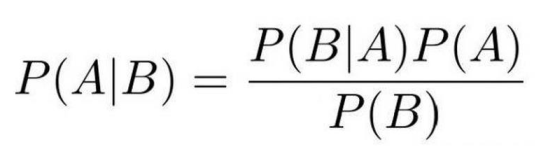博客

  • Go基础:函数声明之方法接受者(函数名之前括号中的内容)

    什么是方法?
    方法与函数的区别是,函数不属于任何类型,方法属于特定的类型。

    普通类型的方法接受者
    Go语言中的 ​​方法(Method)​​ 是一种作用于特定类型变量的函数。这种特定类型变量叫做 ​​接收者(Receiver)​​。
    接收者的概念就类似于其他语言中的​​this​​或者 ​​self​​。

    方法的定义格式如下:

    func (接收者变量 接收者类型) 方法名(参数列表) (返回参数) {
    函数体
    }

    其中,接收者变量:接收者中的参数变量名在命名时,官方建议使用接收者类型名称首字母的小写,而不是​​self​​、​​this​​之类的命名。例如,​​Person​​类型的接收者变量应该命名为 ​​p​​,​​Connector​​类型的接收者变量应该命名为​​c​​等。
    接收者类型:接收者类型和参数类似,可以是指针类型和非指针类型。
    方法名、参数列表、返回参数:具体格式与函数定义相同。

    举个栗子,func ( x DDDD) FOO(var type) ( ret type , err Errot),这里来说一下 x DDDD是什么意思。

    在go语言中,没有类的概念但是可以给类型(结构体,自定义类型)定义方法。

    所谓方法就是定义了接受者的函数,方法和函数只差了一个,那就是方法在 func 和标识符之间多了一个参数。接受者定义在func关键字和函数名之间:

    type Person struct {
        name string
        age int
    }
    
    func (p Person) say() {
        fmt.Printf("I'm %s,%d years old\n",p.name,p.age)
    }

    有了对方法及接受者的简单认识之后,接下来主要谈一下接受者的类型问题。

    接收者有两种,一种是值接收者,一种是指针接收者。顾名思义,值接收者,是接收者的类型是一个值,是一个副本,方法内部无法对其真正的接收者做更改;指针接收者,接收者的类型是一个指针,是接收者的引用,对这个引用的修改之间影响真正的接收者。

    情况一:接受者是struct

    package main
    
    import "fmt"
    
    type Person struct {
    name string
    age int
    }
    func (p Person) say() {
    fmt.Printf("I'm %s,%d years old\n",p.name,p.age)
    }
    func (p Person) older(){
        p.age = p.age +1
    }
    func main() {
        var p1 Person = Person{"zhansan",16}
        p1.older()
        p1.say()
        //output: I'm zhangsan,16 years old
        var p2 *Person = &Person{"lisi",17}
        p2.older()
        p2.say()
        //output: I'm lisi,17 years old
    }

    对于p1的调用,读者应该不会有什么疑问。
    对于p2的调用可能存在这样的疑问,p2明明是个指针,为什么再调用了older方法之后,打印结果还是17 years old?
    方法的接受者是Person而调用者是*Person ,其实在p2调用时存在一个转换p2.older() -> *p2.older(); p2.say() -> *p2.say()
    *p2是什么想必读者也是明白的(就一个p2指向Person实例)。那么疑问也就自然的解开了,方法执行时的接受者实际上还是一个值而非引用。

    情况二:接受者是指针

    package main
    
    import "fmt"
    
    type Person struct {
    name string
    age int
    }
    func (p *Person) say() {
    fmt.Printf("I'm %s,%d years old\n",p.name,p.age)
    }
    func (p *Person) older(){
        p.age = p.age +1
    }
    func main() {
        var p1 Person = Person{"zhansan",16}
        p1.older()
        p1.say()
        //output: I'm zhangsan,17 years old
        var p2 *Person = &Person{"lisi",17}
        p2.older()
        p2.say()
        //output: I'm lisi,18 years old
    }

    p1的调用中也存在一个转换,
    p1.older -> *p1.older
    p1.say() -> *p1.say()

    在举一个清晰的调用例子:

    我们参照着来写一下 Go 的方法定义。

    首先,我们是先要定义一个类型,比如就是 user 好了,然后我们再定义方法。

    type user struct {
            name string
            email string
    }
    
    func (u user) notify() {
            fmt.Println("Email is %d", u.email)
    }
    
    func (u *user) changeEmail(email string) {
            u.email = email
    }

    我们定义了两个方法,一个是 notify,它是值接收者方法;还有一个是 changeEmail,它是指针接收者方法。可以看到,值接收者方法,接收者是一个副本,无法修改;指针接收者是引用,可以修改。

    我们再来看一下调用。

    daryl := {"daryl", "daryl@oldexample.com"}
    daryl.changeEmail("daryl@example.com")
    daryl.notify()

    看看,是不是很熟悉!对,就像 php 代码一样,有没有!daryl 就是对象,name 和 email 就是属性,notify 和 changeEmail 就是它的方法。只是,不同的是,我们没有将它放到 class 中,而是用另外一种方式让它们结合了,有了关系!

    再举一个例子:

    type T struct {
    Name string
    }

    func (t T) M1() {
    t.Name = “name1”
    }

    func (t *T) M2() {
    t.Name = “name2”
    }

    M1() 的接收者是值类型 T, M2() 的接收者是值类型 *T , 两个方法内都是改变Name值。

    下面声明一个 T 类型的变量,并调用 M1() 和 M2() 。

    t1 := T{“t1”}

    fmt.Println(“M1调用前:”, t1.Name)
    t1.M1()
    fmt.Println(“M1调用后:”, t1.Name)

    fmt.Println(“M2调用前:”, t1.Name)
    t1.M2()
    fmt.Println(“M2调用后:”, t1.Name)


    M1调用前: t1
    M1调用后: t1
    M2调用前: t1
    M2调用后: name2


    先来约定一下:接收者可以看作是函数的第一个参数,即这样的: func M1(t T), func M2(t *T)。 go不是面向对象的语言,所以用那种看起来像面向对象的语法来理解可能有偏差。

    当调用 t1.M1() 时相当于 M1(t1) ,实参和行参都是类型 T,可以接受。此时在M1()中的t只是t1的值拷贝,所以M1()的修改影响不到t1。

    当调用 t1.M2() => M2(t1),这是将 T 类型传给了 *T 类型,go可能会取 t1 的地址传进去: M2(&t1)。所以 M2() 的修改可以影响 t1 。


  • mac下安装go

    mac下安装go很容易,linux安装也同理。

    一、安装

    安装: brew install go
    验证 :go version

    二、配置GOPATH

    1. 查看环境变量

    go env

    2. 配置环境变量

    cd ~
    ls -all 查看是否有.bash_profile文件,如果没有,则vim创建。

    输入如下:

    export GOPATH=/Applications/JD/go
    export GOBIN=$GOPATH/bin
    export PATH=$PATH:$GOBIN

    使立即生效
    source ~/.bash_profile

    三、说明

    GOROOT:安装目录(go语言安装目录)。
    GOPATH:工程目录(自己工程项目目录)。
    GOBIN:可执行文件目录。
    PATH:将go可执行文件加入PATH中,使GO命令与我们编写的GO应用可以全局调用。

    GOPATH包含三个目录:bin、pkg、src。
    src目录:源文件。
    pkg目录:编译好的库文件,主要是*.a文件。
    bin目录:可执行文件。

    注意:千万不要把GOPATH设置成go的安装路径。

  • linux 后台运行程序不挂起的方法

    需求:让程序在后台跑后,不会占据终端,我们可以用终端做别的事情

    使用nohup和&使程序在后台运行
    命令格式:nohup Command [ Arg … ] [ & ]
    比如:

    nohup ./test > out.log 2>&1 &

    解释:nohup就是不挂起的意思,将可执行文件test直接放在后台运行,并把终端输出存放在当前目录下的out.log文件中。当客户端关机后重新登陆服务器后,直接查看out.log即可

    如何查看后台运行的程序

    jobs -l
    jobs命令只看当前终端生效的,关闭终端后,在另一个终端jobs已经无法看到后台跑得程序了,此时利用ps(进程查看命令)

    ps -u
    该命令查看属于当前用户的进程信息 ,若想查看别的信息,可以学习ps命令的其他用法。

    如何中止后台运行的程序
    使用命令kill -9 pid即可。

    常用任务管理命令

    # jobs      //查看任务,返回任务编号n和进程号

    # bg  %n   //将编号为n的任务转后台运行

    # fg  %n   //将编号为n的任务转前台运行

    # ctrl+z    //挂起当前任务

    # ctrl+c    //结束当前任务

    描述
    nohup 命令运行由 Command参数和任何相关的Arg参数指定的命令,忽略所有挂断(SIGHUP)信号。在注销后使用 nohup 命令运行后台中的程序:要运行后台中的 nohup 命令,需要添加&到命令的尾部。

    日志记录
    无论是否将 nohup 命令的输出重定向到终端,输出都将附加到当前目录的nohup.out 文件中。如果当前目录的nohup.out文件不可写,输出重定向到$HOME/nohup.out文件中。如果没有文件能创建或打开以用于追加,那么 Command 参数指定的命令不可调用。

    使用时注意
    在当shell中提示了nohup成功后,还需要按终端上键盘任意键退回到shell输入命令窗口,然后通过在shell中输入exit来退出终端;如果在nohup执行成功后直接点关闭程序按钮关闭终端的话,这时候会断掉该命令所对应的session,导致nohup对应的进程被通知需要一起shutdown,起不到关掉终端后调用程序继续后台运行的作用。

  • 产品设计的时候需要考虑到的15个隐形需求

    俗话说,计划赶不上变化快,无论需求文档做得如何细致,考虑得如何周全,总会有些难以预料的需求变更在每天困扰着我们。但是,虽然世界充满未知的变化,但是有一些大的方向还是可以把握的,无论是产品运营还是开发人员,都可以在需求确立以及需求评审时多多考虑一下这些方面,

    转载此文不是为自己看,是准备下一步给产品同学,因为我是开发……,你懂得 ^_^

    1. 细节变更需求

    在项目初期,如果产品人员没有想清楚需求的细节,那么细节的变更可以说是无法避免的。那么作为开发人员唯一能做的就是,在设计程序结构和逻辑的时候,尽量预留出可扩展的能力。比如模块的增删,字段的增减,页面样式的微调等,除此之外也没什么好办法了。别灰心,这都不是事儿。

    2. 跨平台需求

    跨平台需求有时候来的非常隐蔽,往往最初规划的时候感觉可以先在一个平台尝试一下,比如先规划了 PC 端,但是 PC 端的某些功能又会忽然很急促的想移植到移动端。

    而需求人员往往会想当然的认为,功能差不多,只要挪一下就可以了(平移过去/拼过去)。或者是,页面长的差不多,就改成移动端的大小就可以了(缩一下)。殊不知各个平台无论在架构部署,还是操作体验上都有着天壤之别,如果不提前规划好,那必然是个大坑。

    3. 扩展需求

    无论是什么样的业务,随着业务量的增长,以及产品运营人员欲望的膨胀,都会催生出各种扩展需求。任何固定数量的,都会增加。任何单一需要的,都会变成多个。

    比如页面上设计了三个商品推荐位,就要预留出变成六个、九个,甚至分页的能力。一个接口是给某个业务专用的,某天就可能变成通用的。一个简单的静态页面,某天就可能变成附带管理后台的复杂系统。对于扩展性需求,要反复确认,不必过度优化,但也要留出合理的扩展空间。

    4. 异常流需求

    异常流需求往往容易被忽略,或者多有疏漏。常见的异常流有图片数据加载不出,图片不存在,接口挂掉,网速慢,未登录,登录态丢失,查询出错,查询无数据,内容溢出,用户输入溢出,用户输入非法,视觉遮挡不可用等等等等。

    那么,对应这些异常流情况,就要有配套的前端提示给用户,引导用户进行其他操作。这些异常流往往会在设计稿和文档中遗漏掉,比如各种异常提示浮层,需要登录态的操作,结果登录态丢失等等,都需要有对应的引导。

    5. 内容运营需求

    所有静态的内容,都可能变成运营需求。静态广告位可能变成轮播广告位,轮播广告位可能变成需要运营后台填写数据,而不是直接写死在页面里。或者某一天可能变成从另外一个自动数据源拉取数据。

    关于内容运营需求,评审初期可以确认好运营频次,如果是个把月才改一次的,几乎不耗人力的,那也没必要都搞工具。但是如果每天改一次,或者感觉运营内容的时间已经影响到正常的工作,或者远远大于写个工具的时间,那还是老老实实开发个运营工具吧。

    6. 内容校验需求

    上面既然说到运营工具了,那么作为运营工具一定是由运营人员自己来填写。既然是非技术人员填写,操作就难免要傻瓜一点,或者说非技术一点,尽量操作简洁,并且可以校验输入。如果因为运营人员多打了个空格,或者多写了个英文逗号系统就挂了,那应该算谁不尽责呢?

    还有,能分别运营的字段要分别运营,因为有的时候虽然内容看上去是合在一起的,但是经常会有部分修改的需求,不如分开两个字段。比如广告位链接和埋点 tag,链接可能经常换,但固定位置的 tag 值就不会换,所以分开运营会好一些。

    7. 内容复用需求

    运营同学的工作是很辛苦的,设想一下每天一边开着 excel ,一边开着你的运营系统一个字段一个字段填写的时候,就知道画面有多美了。所以,运营填写的数据一定是有复用需求的。

    比如 h5 页面上运营的数据,有可能还需要给原生 app 使用,甚至给 pc 端也用一套数据。一个广告图片和链接,可能被插入到多个页面的顶部或底部,一起更新。多多沟通复用需求,可以随手拯救一大波运营妹子。

    8. 内容历史需求

    既然运营妹子这么不容易,那么工作量 KPI 如何衡量呢?这么辛苦再没人知道不是太惨了?所以,运营的数据一般是要有历史的。

    如果就一个坑位,每次都改掉内容来更新,上一次的就没了,那么鬼知道我一天改了多少次?一周做了多少次更新?当然,这里更偏向工具类的需求了,不过我重点要说的是,有运营需求,就可能有运营的历史记录需求。

    9. 排序&打标需求

    排序需求其实也是内容运营需求的一种,无论是运营填写的还是自动拉取的内容,永远都会有调整顺序的需求。不同的坑位对应不同的关注度,不同的视觉焦点,浏览路径。运营往往需要通过调整位置或者加些标记来突出某些内容。

    比如商品列表,可能近期有几个商品比较好卖,就挪到前面,打上 hot 或者 new 的标记,从而促成更多的销量。对于排序和打标需求,往往从后台开始就要预留可扩展字段,到前端也要可以方便的调整位置和加 icon 标记才行。

    10. 筛选需求

    对应于排序和打标,筛选也是经常用到的。比如我搜集了一坨数据,又只想挑一部分来展示,这时候往往需要一个可以方便操作的地方,类似帖子加精,评论置顶等等。商品类的数据筛选需求就更多啦,不过一般可以集成在搜索功能中,作为通用接口提供。但是,运营同学手动填写的数据再进行筛选,那功能就只能业务侧自己设计了,可以根据需要增加不同的筛选字段供运营同学填写。

    11. 数据统计需求

    数据统计需求是很容易失控的一种需求,产品运营最初往往觉得我要个 PV UV 啥的就够用了,过几天可能说能不能统计下这个按钮的点击量,再过几天可能恨不得把所有的操作都埋点,再加上访问路径、购买路径、转化率、蹦失率、页面停留时间、点击热图、鼠标轨迹……再给我出个月度季度报表,趋势图等等。

    这里,对于数据统计需求一定要评审时梳理好,甚至我觉得可以独立于正常的需求,作为单独的数据统计需求整体梳理后提出。

    12. 翻旧账需求

    我实在找不到更贴切的词汇了。翻旧帐的意思就是,凡事进到我系统里的数据,都希望有个方便的形式可以看到。比如用户创建的 UGC,一定要有个唯一的地址可以看到这个资源。用户录入的信息,要有个方便的地方可以导出,或者下载 excel。即使当前的需求不需要你展示历史记录或者以前的任何内容,也要预留出方便的查询接口备用。

    13. 报销需求

    这个有点诡异,报销关我鸟事?

    当然关。许多大公司的报销流程都很严格,毕竟是涉及到钱的问题。那么对于涉及到钱的活动来说,唯一的凭据可能就是你数据库里的数据了。所以有关钱的需求,最好开始就确认好报销需要哪些内容,比如用户的真实手机等等(确认是真人参与活动,没有造假),以此来作为最终报销的凭据,否则就只能运营同学自己出血了。

    14. 扩容需求

    当业务量稳步上升时就会伴随着扩容的需求,尤其当访问量骤增的时候,快速扩容就迫在眉睫了。扩容包含很多方面,一些性能方面的问题会在高并发史迅速凸显,比如:查询低效,PHP慢速,无静态化 web,并发压力大等等。

    此时关于性能优化的一切知识都可以派上用场了,静态化、缓存、查询优化、锁表等等。而机器扩容也没那么简单,除了机器内容的复制还有相应服务的批量启动,定时任务的执行,日志的归集等等。

    所以,如果评估时预计业务会有爆发性增长(如微信活动),在资金允许的情况下不妨多准备些机器,总比一发布就挂了强。

    15. 安全需求

    这一点放到了最后,同样也是最重要的。安全问题包含的范围非常广泛,虽然有专业的同事负责安全以及运维相关的工作,但是在需求初期如果能稍微做些防范就会避免很多问题。一般的公司都会有个基础的安全规范,比如如何防止 XSS, CSRF 攻击,如何防止 SQL 注入,如何屏蔽脚本攻击等。

    还有一些外部接口需要鉴权的,有时可能做了基本的鉴权,确没有更高级的防护。比如一个人虽然登录了,可以看到自己的某些资料,但是如果这个登录的用户还可以通过相同的接口查看其他人的某些信息,那就是安全问题了。有可能这个信息是存储在相对独立的表中,并没有严格挂在这个用户id下,那么查询的时候就一定要再检查一下数据和用户的对应关系。

    对于安全需求,普通前后台开发人员能做的其实并不多,能按部就班做好这些基础防护就不容易了。加上公司公共的安全扫描平台,基本上可以杜绝绝大部分安全问题了。之所以写到这里单独列一条,还是希望大家要对安全足够重视。


    本文由 @姬小光 原创发布于人人都是产品经理。

  • 使用 Python 进行社交媒体情感分析入门

    自然语言处理(NLP)是机器学习的一种,它解决了口语或书面语言和计算机辅助分析这些语言之间的相关性。日常生活中我们经历了无数的 NLP 创新,从写作帮助和建议到实时语音翻译,还有口译。

    本文研究了 NLP 的一个特定领域:情感分析。重点是确定输入语言的积极、消极或中性性质。本部分将解释 NLP 和情感分析的背景,并探讨两个开源的 Python 包。第 2 部分将演示如何开始构建自己的可扩展情感分析服务。

    在学习情感分析时,对 NLP 有一个大体了解是有帮助的。本文不会深入研究数学本质。相反,我们的目标是阐明 NLP 中的关键概念,这些概念对于将这些方法实际结合到你的解决方案中至关重要。

    自然语言和文本数据

    合理的起点是从定义开始:“什么是自然语言?”它是我们人类相互交流的方式,沟通的主要方式是口语和文字。我们可以更进一步,只关注文本交流。毕竟,生活在 Siri、Alexa 等无处不在的时代,我们知道语音是一组与文本无关的计算。

    数据前景和挑战

    我们只考虑使用文本数据,我们可以对语言和文本做什么呢?首先是语言,特别是英语,除了规则还有很多例外,含义的多样性和语境差异,这些都可能使人类口译员感到困惑,更不用说计算机翻译了。在小学,我们学习文章和标点符号,通过讲母语,我们获得了寻找直觉上表示唯一意义的词的能力。比如,出现诸如 “a”、“the” 和 “or” 之类的文章,它们在 NLP 中被称为停止词,因为传统上 NLP 算法是在一个序列中找到这些词时意味着搜索停止。

    由于我们的目标是自动将文本分类为情感类,因此我们需要一种以计算方式处理文本数据的方法。因此,我们必须考虑如何向机器表示文本数据。众所周知,利用和解释语言的规则很复杂,输入文本的大小和结构可能会有很大差异。我们需要将文本数据转换为数字数据,这是机器和数学的首选方式。这种转变属于特征提取的范畴。

    在提取输入文本数据的数字表示形式后,一个改进可能是:给定一个文本输入体,为上面列出的文章确定一组向量统计数据,并根据这些数据对文档进行分类。例如,过多的副词可能会使撰稿人感到愤怒,或者过度使用停止词可能有助于识别带有内容填充的学期论文。诚然,这可能与我们情感分析的目标没有太大关系。

    词袋

    当你评估一个文本陈述是积极还是消极的时候,你使用哪些上下文来评估它的极性?(例如,文本中是否具有积极的、消极的或中性的情感)一种方式是隐含形容词:被称为 “disgusting”(恶心) 的东西被认为是消极的,但如果同样的东西被称为 “beautiful”(漂亮),你会认为它是积极的。从定义上讲,俗语给人一种熟悉感,通常是积极的,而脏话可能是敌意的表现。文本数据也可以包括表情符号,它带有固定的情感。

    理解单个单词的极性影响为文本的 词袋(bag-of-words)(BoW)模型提供了基础。它分析一组单词或词汇表,并提取关于这些单词在输入文本中是否存在的度量。词汇表是通过处理已知极性的文本形成称为标记的训练数据。从这组标记数据中提取特征,然后分析特征之间的关系,并将标记与数据关联起来。

    “词袋”这个名称说明了它的用途:即不考虑空间位置或上下文的的单个词。词汇表通常是由训练集中出现的所有单词构建的,训练后往往会被修剪。如果在训练之前没有清理停止词,那么停止词会因为其高频率和低语境而被移除。很少使用的单词也可以删除,因为缺乏为一般输入实例提供的信息。

    但是,重要的是要注意,你可以(并且应该)进一步考虑单词在单个训练数据实例之外的情形,这称为 词频(term frequency)(TF)。你还应该考虑输入数据在所有训练实例中的单词计数,通常,出现在所有文档中的低频词更重要,这被称为 逆文本频率指数(inverse document frequency)(IDF)。这些指标一定会在本主题系列的其他文章和软件包中提及,因此了解它们会有所帮助。

    词袋在许多文档分类应用程序中很有用。然而,在情感分析中,当缺乏情境意识的问题被利用时,事情就可以解决。考虑以下句子:

    我们不喜欢这场战争。

    我讨厌下雨天,好事是今天是晴天。

    这不是生死攸关的问题。

    这些短语的情感对于人类口译员来说是有难度的,而且通过严格关注单个词汇的实例,对于机器翻译来说也是困难的。

    在 NLP 中也可以使用称为 “n-grams” 的单词分组。一个二元组考虑两个相邻单词组成的组而不是(或除了)单个词袋。这应该可以缓解诸如上述“不喜欢”之类的情况,但由于缺乏语境意思,它仍然是个问题。此外,在上面的第二句中,下半句的情感语境可以被理解为否定前半部分。因此,这种方法中也会丢失上下文线索的空间局部性。从实用角度来看,使问题复杂化的是从给定输入文本中提取的特征的稀疏性。对于一个完整的大型词汇表,每个单词都有一个计数,可以将其视为一个整数向量。大多数文档的向量中都有大量的零计数向量,这给操作增加了不必要的空间和时间复杂度。虽然已经提出了许多用于降低这种复杂性的简便方法,但它仍然是一个问题。

    词嵌入

    词嵌入(Word embedding)是一种分布式表示,它允许具有相似含义的单词具有相似的表示。这是基于使用实值向量来与它们周围相关联。重点在于使用单词的方式,而不仅仅是它们的存在与否。此外,词嵌入的一个巨大实用优势是它们关注于密集向量。通过摆脱具有相应数量的零值向量元素的单词计数模型,词嵌入在时间和存储方面提供了一个更有效的计算范例。

    以下是两个优秀的词嵌入方法。

    Word2vec

    第一个是 Word2vec,它是由 Google 开发的。随着你对 NLP 和情绪分析研究的深入,你可能会看到这种嵌入方法。它要么使用一个 连续的词袋(continuous bag of words)(CBOW),要么使用一个连续 skip-gram 模型。在 CBOW 中,一个单词的上下文是在训练中根据围绕它的单词来学习的。连续 skip-gram 学习倾向于围绕给定的单词学习单词。虽然这可能超出了你需要解决的问题,但是如果你曾经面对必须生成自己的词嵌入情况,那么 Word2vec 的作者就提倡使用 CBOW 方法来提高速度并评估频繁的单词,而 skip-gram 方法更适合嵌入稀有单词更重要的嵌入。

    GloVe

    第二个是 用于词表示的全局向量(Global Vectors for Word Representation)(GloVe),它是斯坦福大学开发的。它是 Word2vec 方法的扩展,试图通过将经典的全局文本统计特征提取获得的信息与 Word2vec 确定的本地上下文信息相结合。实际上,在一些应用程序中,GloVe 性能优于 Word2vec,而在另一些应用程序中则不如 Word2vec。最终,用于词嵌入的目标数据集将决定哪种方法最优。因此,最好了解它们的存在性和高级机制,因为你很可能会遇到它们。

    创建和使用词嵌入

    最后,知道如何获得词嵌入是有用的。在第 2 部分中,你将看到我们通过利用社区中其他人的实质性工作,站到了巨人的肩膀上。这是获取词嵌入的一种方法:即使用现有的经过训练和验证的模型。实际上,有无数的模型适用于英语和其他语言,一定会有一种模型可以满足你的应用程序,让你开箱即用!

    如果没有的话,就开发工作而言,另一个极端是培训你自己的独立模型,而不考虑你的应用程序。实质上,你将获得大量标记的训练数据,并可能使用上述方法之一来训练模型。即使这样,你仍然只是在理解你输入文本数据。然后,你需要为你应用程序开发一个特定的模型(例如,分析软件版本控制消息中的情感价值),这反过来又需要自己的时间和精力。

    你还可以对针对你的应用程序的数据训练一个词嵌入,虽然这可以减少时间和精力,但这个词嵌入将是特定于应用程序的,这将会降低它的可重用性。

    可用的工具选项

    考虑到所需的大量时间和计算能力,你可能想知道如何才能找到解决问题的方法。的确,开发可靠模型的复杂性可能令人望而生畏。但是,有一个好消息:已经有许多经过验证的模型、工具和软件库可以为我们提供所需的大部分内容。我们将重点关注 Python,因为它为这些应用程序提供了大量方便的工具。

    SpaCy

    SpaCy 提供了许多用于解析输入文本数据和提取特征的语言模型。它经过了高度优化,并被誉为同类中最快的库。最棒的是,它是开源的!SpaCy 会执行标识化、词性分类和依赖项注释。它包含了用于执行此功能的词嵌入模型,还有用于为超过 46 种语言的其他特征提取操作。在本系列的第二篇文章中,你将看到它如何用于文本分析和特征提取。

    vaderSentiment

    vaderSentiment 包提供了积极、消极和中性情绪的衡量标准。正如 原论文 的标题(《VADER:一个基于规则的社交媒体文本情感分析模型》)所示,这些模型是专门为社交媒体文本数据开发和调整的。VADER 接受了一组完整的人类标记过的数据的训练,包括常见的表情符号、UTF-8 编码的表情符号以及口语术语和缩写(例如 meh、lol、sux)。

    对于给定的输入文本数据,vaderSentiment 返回一个极性分数百分比的三元组。它还提供了一个单个的评分标准,称为 vaderSentiment 复合指标。这是一个在 [-1, 1] 范围内的实值,其中对于分值大于 0.05 的情绪被认为是积极的,对于分值小于 -0.05 的被认为是消极的,否则为中性。

    在第 2 部分中,你将学习如何使用这些工具为你的设计添加情感分析功能。


    本文由 LCTT 原创编译,Linux中国 荣誉推出

  • python中XPATH 要想获取的东西里不分段,不变成列表就用STRING(),不用TEXT()

    python中XPATH 要想获取的东西里不分段,不变成列表就用STRING(),不用TEXT()

    requests配合xpath来抓网站数据的时候,不像selenium+xpath。

    selenium有  find_element  find_elements,区别是带S ,查找第一个元素,和查找所有元素。

    requests只有xpath,简单粗暴的直接查找所有元素。所以tag1,要带下标[0]来输出第一个对象,并且用.text来输出文字信息。

    tag2,带下标[0]来输出第一个对象,并且用.text来输出文字信息。但是由于对象中有<br>标签,所以只能取得第一个<br>标签前面的数据。

    tag3,我们在xpath规则中加入.text()规则,取得这个标签中的文字信息。由于有<br>标签,文字信息会因为<br>而分割称为列表。

    我们可以自己重组列表,转为字符串:

    b = [str(i) for i in tag3]
    str = ''.join(b)
    print('tag3-str-->',str)

    或者不使用text()规则使用xpath(‘string(.)’):

    print('tag2-->',tag2)
    print('tag2[0]-string-->',tag2[0].xpath('string(.)'))
    print('tag2[1]-string-->',tag2[1].xpath('string(.)'))

    两种方式都可以正常获取td标签中带br标签的信息。

  • mysql5.7和mysql5.5对group by 取最新数据的不同处理方式

    mysql 用 group by 查询时,会自动保留   对应组 ‘最先搜索出来的数据’,但这时数据可能不是最新的

    如何才能获取‘最新数据’ 呢,这需要根据mysql的版本来“区别对待”

    原因:在mysql5.7中,如果不加limit,系统会把order by优化掉。

    在mysql5.7手册的8.2.2.1中有解释:

    子查询的优化是使用半连接的策略完成的(The optimizer uses semi-join strategies to improve subquery execution)

    使用半连接进行优化,子查询语句必须满足一些标准(In MySQL, a subquery must satisfy these criteria to be handled as a semi-join)。

    其中一个标准是:必须不是一个包含了limit和order by的语句(It must not have ORDER BY with LIMIT.)

    对于mysql 5.5版本

    select * from (

    select * from table_name order by create_time desc

    ) as t
    group by t.id;
    EOT;

    对于mysql 5.7版本,需要加入limit限制,否则不生效

    select * from (

    select * from table_name order by create_time desc limit 100000

    ) as t
    group by t.id;
    EOT;


  • python爬虫系列之 xpath语法

    # XPath 基础表达式:

    /node       表示在xml文档的根目录查找结点名称为node的结点
    ./node      表示在当前结点下查找结点名称为node的结点
    //node      表示在xml文档中递归查找结点名称为node的节点
    //*      表示在xml文档中查询所有的结点,但是排除文本节点
    //node()      表示在xml文档中查询所有结点,包含文本节点
    //text()      表示在xml文档中递归查找所有的文本节点
    //*/text()[contains(., ‘test’)]      表示在xml文档中递归查找所有结点,条件为该结点的文本节点包含”test”
    //node[@id]      表示在xml文档中递归查找结点名称为node的结点,条件为该结点必须含有id属性
    //node[id]      表示在xml文档中递归查找结点名称为node的结点,条件为该结点必须含有结点名称为id的结点
    //nodes[node/id]      表示递归查找nodes结点,条件为nodes结点下必须有node结点,且node结点下必须有id结点
    //nodes[@id]/node[id]      表示递归查找含有id属性的nodes结点下的node结点,条件为node结点下必须含有id结点
    //nodes[@id]/node[0]      表示递归查找含有id属性的nodes结点下的第一个node结点
    //nodes[@id]/node[last()]      表示递归查找含有id属性的nodes结点下的最后一个node结点
    //nodes/node[position() < 4]      表示递归查找nodes结点下索引小于4的node结点
    //nodes[@id]/node[position() < last()]      递归查找含有id属性的nodes结点下除最后一个结点外的node结点
    /nodes/child::node()[name()=’node’]      表示查找nodes结点下结点名称为node的子结点
    /nodes/child::node      等同于/nodes/node表示查找nodes下的node子结点
    /nodes/node/attribute::id      等同于/nodes/node/@id表示查找nodes结点下的node结点的id属性
    //nodes[@id=’1001′]/node[starts-with(@id, ‘1’)]      表示查找id属性为1001的nodes结点下的id属性以1开头的node结点
    //@*[ends-with(., ‘1’)]      表示查找以1结尾所有属性
    (//* | //@*)[substring(name(), 1, 5) = ‘class’]      查找所有结点名称或属性名称的1到5之间的字符等于’class’的结点
    //node[@attr!=’-2′ and @attr!=’2′]      查找所有node节点,其attr属性不等于2和-2

    # XPath 文档轴用途:

    self      选择当前节点
    parent      选择当前节点的父节点
    child      选择当前节点的所有子节点
    attribute      选择当前节点的所有属性
    ancestor      选择当前节点的所有祖先,包括父节点、父节点的父节点等等
    ancestor-or-self      选择当前节点的祖先以及当前节点本身
    descendant      选择当前节点的所有后代,包括子节点、子节点的子节点等等
    descendant-or-self      选择当前节点的后代以及当前节点本身
    preceding      选择整个文档中出现在当前节点前面的所有节点
    preceding-sibling      选择文档中出现在当前节点前面的所有同胞节点(即与当前节点同级的节点)
    following      选择整个文档中出现在当前节点后面的所有节点
    following-sibling      选择文档中出现在当前节点后面的所有同胞节点(即与当前节点同级的节点)
    namespace      选择当前节点的所有名称空间节点

    1.2 常用规则

    获取文本
    a/text()       获取 a 下的文本
    a//text()       获取 a 下所有元素的文本
    //a[text()=’下一页’]       获取文本为下一页的 a 元素

    获取属性
    nodename        选取此节点的所有子节点
    /       从当前节点选取直接子节点
    //       从当前节点选取子孙节点
    .       选取当前节点
    ..       选取当前节点的父节点
    @       选取属性
    *       匹配任何元素节点
    @*       匹配任何属性节点
    node()       匹配任何类型的节点

  • 朴素贝叶斯算法

    一篇很好的介绍贝叶斯算法的帖子,即使高数考个位数也能看懂(比如我 ^-^)。贝叶斯算法是由英国数学家托马斯·贝叶斯提出的,这个算法的提出是为了解决“逆向概率”的问题。

    在前贝叶斯时代处理概率问题的时候,总是先取一定假设(比如抛硬币时,每次出现正反面的概率相同),然后在假设下讨论一定事件的概率(比如说连续出现 10 次正面的概率)。「逆概率」则反过来考虑问题,比如说,如果连续出现 10 次正面,我们想知道一次抛硬币时出现正反面的概率。贝叶斯定理的相关论文在贝叶斯去世后才发表,此后法国大数学家拉普拉斯对这一理论进行了深入的研究,使之成为我们今天使用的形式。首先我们先来解释下正向概率与逆向概率的含义:

    正向概率:假设一个箱子里有5个黄色球和5个白色球,随机从箱子里拿出一个球,请问取出的是黄球的概率是多少?很容易计算P(黄球)= N(黄球)/N(黄球)+ N(白球) =

    5/5+5 = 1/2。
    逆向概率:起初我们并不知道箱子里有多少个球,我们依次从箱子里取出10个球,发现这个10个球中有7个白球,3个黄球,那么我们会根据我们观察到的结果去推测箱子里白球与黄球的分布比例大概是7:3,但是我们无法推测出箱子里的球的个数。

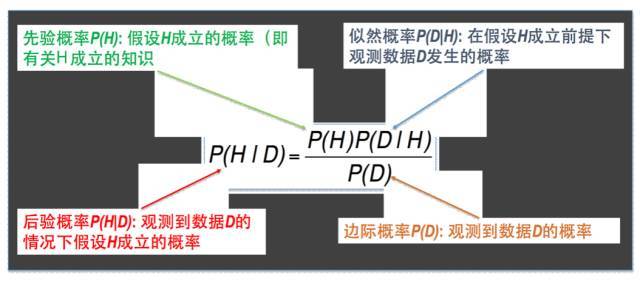
    此公式表示两个互换的条件概率之间的关系,他们通过联合概率关联起来,这样使得我们知道P(D|H)的情况下去计算P(H|D)成为了可能,而我们的贝叶斯模型便是通过贝叶斯准则去计算某个样本在不同类别条件下的条件概率并取具有最大条件概率的那个类型作为分类的预测结果。

    贝叶斯算法是一种基于概率统计的机器学习算法,它会计算出每种情况发生的概率,然后对其进行分类,贝叶斯算法经常用于文本分类问题和垃圾邮件过滤问题。假设有一篇新闻报道news report,我们使用贝叶斯算法来判断它们的类别,结果如下:
    p(politics|news) = 0.2
    p(entertainment|news) = 0.4
    p(sports|news) = 0.7
    因为p(sports|news)的概率最大,所以我们判断这篇新闻报道为体育类报道。“|”左边为要判断的类别,右边是我们给定的文章。

    贝叶斯公式推导
    接下来,我们将通过一个例子来推导贝叶斯公式。在一所学校里,男生和女生的比例分别是60%和40%,男生全部穿长裤,女生一半穿长裤,一半穿裙子。现迎面走来一个同学,你只能看清他(她)穿的是长裤,而无法分辨出他(她)的性别,请问他(她)是女生的概率?

    下面我们逐步计算这个问题:
    假设学校里的学生总数为N。
    男生人数:N * P(boys),女生人数:N * P(girls)。
    穿长裤的男生人数:N * P(boys) * P(pants|boys),其中P(pants|boys)是条件概率的表达形式,意思是男生中穿长裤的概率。因为男生都穿长裤,所以N * P(boys) * P(pants|boys) = 60% * N。
    穿长裤的女生的人数:N * P(girs) * P(pants|girls) = 0.2 * N。
    穿长裤的总人数:N * P(boys) * P(pants|boys) + N * P(girs) * P(pants|girls)
    穿长裤的同学是女生的概率:P(girl|pants) = N * P(girs) * P(pants|girls) / N * P(boys) * P(pants|boy

    s) + N * P(girs) * P(pants|girls) = P(girs)*P(pants|girls) / P(pants),分母用P(pants)表示穿长裤的概率。
    最终结果:P(girl | pants) = P(pants | girl) * P(girl) / P(pants)
    其中:P(girl)我们称为先验概率,是已知值,在这个例子中P(girl) = 40%。先验概率:根据以往的经验和分析得到的结果,先验概率和其他条件的影响不受样本影响。
    P(girl | pants)我们称为后验概率,根据观察到的结果,去反推是女生的概率。

    换一种更直白的表述:假设学校里面人的总数是 U 个。60% 的男生都穿长裤,于是我们得到了 U * P(Boy) * P(Pants|Boy) 个穿长裤的(男生)(其中 P(Boy) 是男生的概率 = 60%,这里可以简单的理解为男生的比例;P(Pants|Boy) 是条件概率,即在 Boy 这个条件下穿长裤的概率是多大,这里是 100% ,因为所有男生都穿长裤)。40% 的女生里面又有一半(50%)是穿长裤的,于是我们又得到了 U * P(Girl) * P(Pants|Girl) 个穿长裤的(女生)。加起来一共是 U * P(Boy) * P(Pants|Boy) + U * P(Girl) * P(Pants|Girl) 个穿长裤的,其中有 U * P(Girl) * P(Pants|Girl) 个女生。两者一比就是你要求的答案。

    下面我们把这个答案形式化一下:我们要求的是 P(Girl|Pants) (穿长裤的人里面有多少女生),我们计算的结果是 U * P(Girl) * P(Pants|Girl) / [U * P(Boy) * P(Pants|Boy) + U * P(Girl) * P(Pants|Girl)] 。容易发现这里校园内人的总数是无关的,可以消去。于是得到

    P(Girl|Pants) = P(Girl) * P(Pants|Girl) / [P(Boy) * P(Pants|Boy) + P(Girl) * P(Pants|Girl)]

    注意,如果把上式收缩起来,分母其实就是 P(Pants) ,分子其实就是 P(Pants, Girl) 。而这个比例很自然地就读作:在穿长裤的人( P(Pants) )里面有多少(穿长裤)的女孩( P(Pants, Girl) )。

    上式中的 Pants 和 Boy/Girl 可以指代一切东西,所以其一般形式就是:

    P(B|A) = P(A|B) * P(B) / [P(A|B) * P(B) + P(A|~B) * P(~B) ]

    收缩起来就是:

    P(B|A) = P(AB) / P(A)

    其实这个就等于:

    P(B|A) * P(A) = P(AB)

    难怪拉普拉斯说概率论只是把常识用数学公式表达了出来。

    贝叶斯数学表达式

    贝叶斯算法在垃圾邮件过滤中的应用
    给定一封邮件,判定它是否属于垃圾邮件?用D 来表示这封邮件,注意D 由N 个单词组成。我们用h+ 来表示垃圾邮件,h-表示正常邮件。
    有贝叶斯公式可得:
    P(h+ | D) = P(D | h+) * P(h+) / P(D)
    P(h- | D) = P(D | h-) * P(h-) / P(D)
    其中P(h+),P(h-)为先验概率,假如我们有1000封邮件,其中有50封是垃圾邮件,其他都是正常邮件,那么P(h+),P(h-)的概率就是已知的。两个式子的分母都是P(D),所以P(D)对于最终结果的比较是没有影响的。接下来就是要求P(D | h+),P(D | h-)垃圾邮件中或正常邮件中是邮件D的概率。
    我们都知道一封邮件是由许多词构成的,所以我们将P(D | h+)的表达式转化为P(d1,d2,d3……dn | h+),就是看垃圾邮件中出现d1,d2…dn这些词的概率是多少。
    P(d1,d2,d3……dn | h+) = P(d1 | h+) * P(d2 |d1,h+) * P(d3 |d1,d2,h+) …
    这个式子计算起来非常困难,所以在这里我们做一个假设,假设每个词都是独立的并且互不影响,那么这个式子就可以表示为:
    P(d1,d2,d3……dn | h+) = P(d1 | h+) * P(d2 | h+) * P(d3 | h+) …P(dn | h+)
    P(h+ | D) = {P(d1 | h+) * P(d2 | h+) * P(d3 | h+) …P(dn | h+)}* P(h+) / P(D)
    上述这个式子我们就称为朴素贝叶斯公式,朴素贝叶斯公式是对贝叶斯公式的简化,它建立在每个条子互相独立的基础上。
    在现实生活中,我们写的每一句话中词与词之间肯定是有相互联系,如果没有联系,那么这句话是读不通的。那么为什么朴素贝叶斯能够在计算中使用,首先是计算简单,其次对最终结果的影响非常小。
    参考资料
    1.唐宇迪,《机器学习与数据分析实战》课程。
    2.Peter,《机器学习实战》。

  • 推荐系统中冷启动的实施和相关算法

    冷启动(cold start)在整个推荐系统中,是一个重要的开始。推荐系统一般需要在大量的数据基础上才能比较准确的进行推荐,APP的冷启动可能直接决定着这个新用户会不会继续使用,新物品的冷启动也影响着生产者的积极性,所以冷启动很重要。

    冷启动问题分为3类:

    1. 用户冷启动:新来的用户,应该给他推荐什么内容?
    2. 物品冷启动:新来的物品,应该把它推荐给谁?
    3. 系统冷启动:在“一穷二白”的基础上,新来的用户和没有推荐过的物品,怎么建立他们的关联?

    用户冷启动思路

    用户冷启动,最常见的场景就是新用户冷启动。一个新用户转化为老用户的路径是:新用户兴趣获取(构建冷启动用户初始画像)->内容消费和兴趣收敛->沉淀兴趣成为老用户。概括地说,第一步就是“千方百计”获取用户画像或让用户主动产生画像,有几种方法可以考虑。

    利用用户的社会属性,如性别、年龄、地区等。在用户第一次打开APP的时候,很多APP会提示或留有入口供用户填写相关信息。即使用户不主动输入,也可以尝试从外部渠道(渠道画像、矩阵画像、applist等)引入画像信息(但需要注意用户重合度和相关度)。有了这些信息,就可以基于社会属性进行粗颗粒度的个性化推荐。

    利用用户的关系链,可以借助运营活动收集(如支付宝活动收集好友关系、亲子关系)或从外部引入(第三方登录或开放API),基于“人以群分”的道理给用户推荐好友喜欢的内容。

    利用热门内容,对用户“一无所知”的情况下,基于从众心理和二八定律,可尝试给用户推荐热门内容,这种方式主要注意热门的范围和算法,效果会比随机推荐好。利用高质量内容同理。

    (左:微博,右:今日头条)

    用户冷启动的指标可以关注新用户的画像指标(人均兴趣数、画像覆盖率、画像准确率等)及新用户活跃表现(点击率、留存等)。

    假设一款国际APP,基于国籍和性别就能在一开始有一个比较好的推荐效果,它有什么办法获得这些信息?

    1. 显性方式:如前文所说,让用户填写、引导或激励的方式都可以。
    2. 隐性方式:用一些性别/国籍点击差异特别大的内容来猜用户性别、国籍,再开始有偏向的个性化推荐。

    这类隐性探索,选取物品需要有技巧:

    1. 热门:有一定的认知度,物品过于生僻,得到的结果大部分必定是“跳过”。
    2. 代表性和区分性:物品与物品之间要有区分度,能表征用户的不同兴趣。
    3. 多样性:由于人的兴趣多种多样,要注意尽可能覆盖,避免“无可选”的尴尬。

    物品冷启动思路

    利用物品内容推荐:

    1. 物品相似推荐:找到和新物品属于同一类的内容,新物品搭上“顺风车”,进行相似推荐。
    2. 物品相关推荐:基于专家的知识来建立起物品的信息知识库,建立物品之间的相关度。如知识图谱,通过一个已知节点和关系找到另一个节点,进行拓展推荐。
    3. 例如某用户喜欢“周冬雨”(节点),周冬雨是电影《少年的你》的主演,通过这层关系关联到节点“少年的你”,因此将《少年的你》推荐给用户。

    (图片来源于网络)

    相关算法简介

    期间涉及的常用算法有哪些?假设A用户是新用户,只有少量画像。

      1. UserCF:基于用户的协同过滤,通过用户行为计算用户的相似度,找到和A用户相近的B用户,给A用户推荐B用户喜欢的物品。
      2. ItemCF:基于物品的协同过滤,通过用户行为计算物品的相似度,找到和物品a相似的物品b,将物品b推荐给喜欢物品a的用户A。

    (左:UserCF,右:ItemCF)

    1. ContentItemKNN:基于内容的过滤,根据物品的内容特征计算内容的相似度,找到和物品a相似的物品b,将物品b推荐给喜欢物品a的用户A。

    UserCF和ItemCF使用的是同一份用户行为数据,只是统计维度不同。如下图简单示例(1表示用户点击了该物品),UserCF是横向计算用户的相似度,ItemCF是纵向计算物品的相似度。

    UserCF、ItemCF在冷启动问题上都有“第一推动力”的问题。

    UserCF,要让新物品先出现在用户展示列表,才有可能让更多的人对这个物品产生反馈,物品才能扩散出来,所以有一个第一推动力的问题,即第一个用户从哪里发现新物品。

    ItemCF是隔段时间计算用户行为(日志庞大,较耗时)从而计算出物品相似度(如果大量用户看了物品a,同时也看了物品b,即认为这两个物品是相似的),输出一个物品相关度矩阵,新物品加入时并不会自动加入这个矩阵表,也需要有用户先发现这个新物品。

    ContentItemKNN利用物品的内容特征计算物品相关表,可以频繁地更新相关表,没有第一推动力的问题。但它忽视了用户行为,从而忽视了用户行为中所包含的规律,结果精度低,新颖度高,效果一般不如协同过滤。但如果用户行为强烈受某一内容特征的影响,内容过滤算法有亮点。

    前文提及的第一推动力问题,即物品冷启动问题,也称“新物品试投”,有什么办法解决?

    新物品试投是“物品找用户”。如果是“用户找物品”,容易出现马太效应:热门分类曝光多,长尾现象严重。物品找用户的方式有两种:

    1. 随机试投
    2. 兴趣试投

    假设我们定义曝光500次以下的物品是新物品(资讯类产品一般还有时间限制,如6小时内),将新物品和用户表征为多维向量,计算向量的距离,对较活跃用户分发,在冷启动阶段排序加权和重排限制。物品在冷启动阶段会有一个趋于稳定的点击率(或其他综合指标),该点击率是它后续流量分配的依据——根据小流量的点击率表现,表现好的物品进入下一个更大的流量池,表现差的物品被淘汰或降权。梯度流量分发策略是比较常见的个性化推荐“赛马机制”。

    用哪些指标评估物品冷启动效果?

    1. 模型准确度
    2. 单位试投次数
    3. 有效分发覆盖率
    4. 物品优质率
    5. 新物品推荐表现(点击率、时长等)

    另外一点,还需要注意用户的上下文信息,包括时间信息、空间信息,走一些强规则。

    例如电商APP,新用户在夏天登陆,就不应该推出羽绒服;在中秋节登录,就不应该推出端午节的资讯。但这不仅是在冷启动阶段,在整个推荐场景都应该留意用户的上下文信息。


    本文由 @张小喵Miu 原创发布于人人都是产品经理,本文没有经过作者同意,因为不知道怎么联系 -_- ,如需删除请留言。

  • 关于thinkphp6 的一些应用备忘[持续更新……]

    以下主要是针对多应用下的使用:

    1 . 多应用下路由设置:

    在app下创建了一个 index 应用,里面有index控制器,路由需要在 route路由文件夹下创建一个 index(应用名称)的文件夹,下面创建一个 route.php 的路由文件,index应用的路由可以在这里设置:

    use think\facade\Route;
    
    Route::any('/','index');
    Route::any('list/:id','index/fulllist/index');
    Route::any('detail/:id','index/Detail/index');
  • MySQL上的查询优化

    如果是千万数量级的订单数据,一个优质的查询会有非常明显的提速。索引的作用在这里尤其关键。
    
    索引通俗来讲就相当于书的目录,当我们根据条件查询的时候,没有索引,便需要全表扫描,数据量少还可以,一旦数据量超过百万甚至千万,一条查询sql执行往往需要几十秒甚至更多,5秒以上就已经让人难以忍受了。
    
    提升查询速度的方向一是提升硬件(内存、cpu、硬盘),二是在软件上优化(加索引、优化sql;优化sql不在本文阐述范围之内)。
    
    能在软件上解决的,就不在硬件上解决,毕竟硬件提升代码昂贵,性价比太低。代价小且行之有效的解决方法就是合理的加索引。
    
    索引使用得当,能使查询速度提升上万倍,效果惊人。

    索引的类型:

    mysql的索引有5种:主键索引、普通索引、唯一索引、全文索引、聚合索引(多列索引)。

    唯一索引和全文索引用的很少,我们主要关注主键索引、普通索引和聚合索引。

    1)主键索引:主键索引是加在主键上的索引,设置主键(primary key)的时候,mysql会自动创建主键索引;

    2)普通索引:创建在非主键列上的索引;

    3)聚合索引:创建在多列上的索引

    索引的语法:

    查看某张表的索引:SHOW INDEX FROM 表名;

    创建普通索引:ALTER TABLE 表名 ADD INDEX  索引名 (加索引的列)

    创建聚合索引:ALTER TABLE 表名 ADD INDEX 索引名 (加索引的列1,加索引的列2)

    删除某张表的索引:DROP INDEX 索引名 ON 表名;

    EXPLAIN分析SQL语句的效率:

    EXPLAIN列的解释

    table                    显示这一行的数据是关于哪张表的

    type                     这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为const、eq_reg、ref、range、indexhe和ALL

    possible_keys     显示可能应用在这张表中的索引。如果为空,没有可能的索引。可以为相关的域从WHERE语句中选择一个合适的语句

    key                      实际使用的索引。如果为NULL,则没有使用索引。

    key_len               使用的索引的长度。在不损失精确性的情况下,长度越短越好

    ref                       显示索引的哪一列被使用了,如果可能的话,是一个常数

    rows                    MYSQL认为必须检查的用来返回请求数据的行数

    Extra                   关于MYSQL如何解析查询的额外信息。

    Extra字段值含义:

    Distinct                   一旦MYSQL找到了与行相联合匹配的行,就不再搜索了

    Not exists               MYSQL优化了LEFT JOIN,一旦它找到了匹配LEFT JOIN标准的行,就不再搜索了

    Range checked for each Record(index map:#)      没有找到理想的索引,因此对于从前面表中来的每一个行组合,MYSQL检查使用哪个索引,并用它来从表中返回行。这是使用索引的最慢的连接之一

    Using filesort          看到这个的时候,查询就需要优化了。MYSQL需要进行额外的步骤来发现如何对返回的行排序。它根据连接类型以及存储排序键值和匹配条件的全部行的行指针来排序全部行

    Using index            列数据是从仅仅使用了索引中的信息而没有读取实际的行动的表返回的,这发生在对表的全部的请求列都是同一个索引的部分的时候

    Using temporary    看到这个的时候,查询需要优化了。这里,MYSQL需要创建一个临时表来存储结果,这通常发生在对不同的列集进行ORDER BY上,而不是GROUP BY上

    Where used           使用了WHERE从句来限制哪些行将与下一张表匹配或者是返回给用户。如果不想返回表中的全部行,并且连接类型ALL或index,这就会发生,或者是查询有问题不同连接类型的解释(按照效率高低的顺序排序)

    type字段值含义:

    const       表中的一个记录的最大值能够匹配这个查询(索引可以是主键或惟一索引)。因为只有一行,这个值实际就是常数,因为MYSQL先读这个值然后把它当做常数来对待

    eq_ref     连接中,MYSQL在查询时,从前面的表中,对每一个记录的联合都从表中读取一个记录,它在查询使用了索引为主键或惟一键的全部时使用

    ref           这个连接类型只有在查询使用了不是惟一或主键的键或者是这些类型的部分(比如,利用最左边前缀)时发生。对于之前的表的每一个行联合,全部记录都将从表中读出。这个类型严重依赖于根据索引匹配的记录多少—越少越好

    range      这个连接类型使用索引返回一个范围中的行,比如使用>或<查找东西时发生的情况

    index       这个连接类型对前面的表中的每一个记录联合进行完全扫描(比ALL更好,因为索引一般小于表数据)

    ALL         这个连接类型对于前面的每一个记录联合进行完全扫描,这一般比较糟糕,应该尽量避免


    两大引擎MyISAM、InnoDB分析:

    背景:

    数据记录:10024725行

    表索引:  主键、A、AB、ABC

    相同点:

    1.都是B+树的底层实现。

    2.WHERE条件都符合索引最左匹配原则。

    不同点:

    1.MyISAM的存储文件有三个,frm、MYD、MYI 文件;InnoDB的存储文件就两个,frm、ibd文件。总文件大小InnoDB引擎占用空间更小。

    2.InnoDB的存储文件本身就是索引构成,建立新索引的时间比MyISAM快。

    3.MyISAM比InnoDB查询速度快,插入速度也快。

    4.主键区间查询,InnoDB查询更快。字符串区间查询,MyISAM相对更快。

    5.有A、AB、ABC索引的情况下,A OR B 查询,InnoDB查询性能比MyISAM慢。不建议使用OR 条件进行查询。

    6.InnoDB表没有命中到 A、B、C 索引最左原则时,BC组合查询命中了索引,但还是完全扫描,比全表扫描快些。MyISAM是全表扫描。

    软件层面的优化一是合理加索引;二是优化执行慢的sql。此二者相辅相成,缺一不可,如果加了索引,还是查询很慢,这时候就要考虑是sql的问题了,优化sql。实际生产中的sql往往比较复杂,如果数据量过了百万,加了索引后效果还是不理想,使用集群、垂直或水平拆分。


    优化要注意的一些事(重点)

    1. 索引其实就是一种归类方式,当某一个字段属性都不能归类,建立索引后是没什么效果的,或归类就二种(0和1),且各自都数据对半分,建立索引后的效果也不怎么强。

    2. 主键的索引是不一样的,要区别理解。

    3. 当时间存储为时间戳保存的可以建立前缀索引。

    4. 在什么是字段上建立索引,需要根据查询条件而定,不要一上来就建立索引,浪费内存还有可能用不到。

    5. 大字段(blob)不要建立索引,查询也不会走索引。

    6. 常用建立索引的地方:

    1)主键的聚集索引
    2)外键索引
    3)类别只有0和1就不要建索引了,没有意义,对性能没有提升,还影响写入性能
    4)用模糊其实是可以走前缀索引

    7. 唯一索引一定要小心使用,它带有唯一约束,由于前期需求不明等情况下,可能造成我们对于唯一列的误判。

    8. 由于我们建立索引并想让索引能达到最高性能,这个时候我们应当充分考虑该列是否适合建立索引,可以根据列的区分度来判断,区分度太低的情况下可以不考虑建立索引,区分度越高效率越高。

    9. 写入比较频繁的时候,不能开启MySQL的查询缓存,因为在每一次写入的时候不光要写入磁盘还的更新缓存中的数据。

    10. 建索引的目的:

    1)加快查询速度,使用索引后查询有迹可循。
    2)减少I/O操作,通过索引的路径来检索数据,不是在磁盘中随机检索。
    3)消除磁盘排序,索引是排序的,走完索引就排序完成。

    11. 其实建索引的原理就是将磁盘I/O操作的最小化,不在磁盘中排序,而是在内存中排好序,通过排序的规则去指定磁盘读取就行,也不需要在磁盘上随机读取。

    12. 由于磁盘整理磁盘碎片,所有有的时候我们也可以通过建立聚集索引来减少这一类的问题。

    13. 当一个表中有100万数据,而经常用到的数据只有40万或40万以下,是不用考虑建立索引的,没什么性能提升。

    14. 什么时候不适合建立索引:

    1)频繁更新的字段不适合建立索引
    2)where条件中用不到的字段不适合建立索引,都用不到建立索引没有意义还浪费空间
    3)表数据可以确定比较少的不需要建索引
    4)数据重复且发布比较均匀的的字段不适合建索引(唯一性太差的字段不适合建立索引),例如性别,真假值
    5)参与列计算的列不适合建索引,如:

    select * from table where amount+100>1000 /*这样是不走索引的,可以改造为如下*/

    select * from table where amount>1000-100。

    15. 使用count统计数据量的时候建议使用count(*)而不是count(列),因为count(*)MySQL是做了优化的。

    16. 二次SQL查询区别不大的时候,不能按照二次执行的时间来判断优化结果,没准第一次查询后又保存缓存数据,导致第二次查询速度比第二次快,很多时候我们看到的都是假象。

    17. 什么时候开MySQL的查询缓存,交易系统(写多、读少)、SQL优化测试,建议关闭查询缓存,论坛文章类系统(写少、读多),建议开启查询缓存。

    18. Explain 执行计划只能解释SELECT操作。

    19. 查询优化可以考虑让查询走索引,走索引能提升查询速度,索引覆盖是最快的,如下就是让分页走覆盖索引提高查询速度。
    20. 子查询比join快,虽然规律不绝对,但对大表多数有效

    21. 复杂SQL语句优化的思路:

    1)首先考虑在一个表中能不能取到有关的信息,尽量少关联表
    2)关联条件争取都走主键或外键查询条件,能走到对应的索引
    3)争取在满足业务上走小集合数据查找
    4)INNER JOIN 和子查询哪个更快,场景不一致速度也不同

    22. where条件多条件一定要按照小结果集排大结果集前面

    23. 尽量避免大事务操作,提高系统并发能力,有时无法避免,改用定时器延迟处理。

    24. 什么情况不走索引:

    SELECT ` famount ` FROM ` fentrust ` WHERE ` famount `+10=30;– 不会使用索引,因为所有索引列参与了计算

    SELECT `famount` FROM `fentrust` WHERE LEFT(`fcreateTime`,4) <1990; — 不会使用索引,因为使用了函数运算,原理与上面相同

    SELECT * FROM ` fuser` WHERE `floginname` LIKE‘138%’ — 走索引

    SELECT * FROM ` fuser ` WHERE ` floginname ` LIKE “%7488%” — 不走索引 — 正则表达式不使用索引,这应该很好理解,所以为什么在SQL中很难看到regexp关键字的原因 — 字符串与数字比较不使用索引;

    EXPLAIN SELECT * FROM `a` WHERE `a`=1 — 不走索引

    select * from fuser where floginname=’xxx’ or femail=’xx’ or fstatus=1 –如果条件中有or,即使其中有条件带索引也不会使用。换言之,就是要求使用的所有字段,都必须建立索引, 我们建议大家尽量避免使用or 关键字

    25. 如果MySQL估计使用全表扫描要比使用索引快,则不使用索引。

    26. 使用UNION ALL 替换OR多条件查询并集。

    27. 在大数据表删除也是一个问题,避免删除过程数据库奔溃,可以考虑分配删除,一次删1000条,删完后等一会继续删除

    28. 大数据表优化:

    1)建立汇总表
    2)建立流水表
    3)分库分表

    29. 建立汇总表,首先不用考虑分库分表,使用定时器定时去汇总。

    30. 分表,可以按水平或垂直切分。垂直分表其实就是将经常使用的数据和很少使用的数据进行垂直的切分,切分到不同的库,提高单库的数据容量,如:前3个月之前的交易记录就可以放另一个库中。

    31. 建立流水表,数据冗余,有这个表记录流水变更就不用去写复杂SQL计算流水。

    32. 分库,多数据库相同库结构,分发处理并发能力,但同时带来了数据同步问题,也可以使用分库做主备分离

    32. SQL优化顺序:

    1)尽量少作计算。
    2)尽量少 join。
    3)尽量少排序。
    4)尽量避免 select *。
    5)尽量用 join 代替子查询。
    6)尽量少 or。
    7)尽量用 union all 代替 union。
    8)尽量早过滤。
    9)避免类型转换。
    10)优先优化高并发的 SQL,而不是执行频率低某些“大”SQL。
    11)从全局出发优化,而不是片面调整。
    12)尽可能对每一条运行在数据库中的SQL进行 Explain。

    33. 如下是30条大数据表优化要点:

    1)对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引。

    2)应尽量避免在 where 子句中对字段进行 null 值判断,否则将导致引擎放弃使用索引而进行全表扫描,如:select id from t where num is null可以在num上设置默认值0,确保表中num列没有null值,然后这样查询:select id from t where num=0

    3)应尽量避免在 where 子句中使用!=或<>操作符,否则引擎将放弃使用索引而进行全表扫描。

    4)应尽量避免在 where 子句中使用or 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描,如:select id from t where num=10 or num=20可以这样查询:select id from t where num=10 union all select id from t where num=20

    5)in 和 not in 也要慎用,否则会导致全表扫描,如:select id from t where num in(1,2,3) 对于连续的数值,能用 between 就不要用 in 了:select id from t where num between 1 and 3

    6)下面的查询也将导致全表扫描:select id from t where name like ‘李%’若要提高效率,可以考虑全文检索。

    7)如果在 where 子句中使用参数,也会导致全表扫描。因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推迟到运行时;它必须在编译时进行选择。然 而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。如下面语句将进行全表扫描:select id from t where num=@num可以改为强制查询使用索引:select id from t with(index(索引名)) where num=@num

    8)应尽量避免在 where 子句中对字段进行表达式操作,这将导致引擎放弃使用索引而进行全表扫描。如:select id from t where num/2=100应改为:select id from t where num=100*2

    9)应尽量避免在where子句中对字段进行函数操作,这将导致引擎放弃使用索引而进行全表扫描。如:select id from t where substring(name,1,3)=’abc’ ,name以abc开头的id 应改为: select id from t where name like ‘abc%’

    10)不要在 where 子句中的“=”左边进行函数、算术运算或其他表达式运算,否则系统将可能无法正确使用索引。

    11)在使用索引字段作为条件时,如果该索引是复合索引,那么必须使用到该索引中的第一个字段作为条件时才能保证系统使用该索引,否则该索引将不会被使用,并且应尽可能的让字段顺序与索引顺序相一致。

    12)不要写一些没有意义的查询,如需要生成一个空表结构:select col1,col2 into #t from t where 1=0 这类代码不会返回任何结果集,但是会消耗系统资源的,应改成这样: create table #t(…)

    13)很多时候用 exists 代替 in 是一个好的选择:select num from a where num in(select num from b) 用下面的语句替换: select num from a where exists(select 1 from b where num=a.num)

    14)并不是所有索引对查询都有效,SQL是根据表中数据来进行查询优化的,当索引列有大量数据重复时,SQL查询可能不会去利用索引,如一表中有字段sex,male、female几乎各一半,那么即使在sex上建了索引也对查询效率起不了作用。

    15)索引并不是越多越好,索引固然可 以提高相应的 select 的效率,但同时也降低了 insert 及 update 的效率,因为 insert 或 update 时有可能会重建索引,所以怎样建索引需要慎重考虑,视具体情况而定。一个表的索引数最好不要超过6个,若太多则应考虑一些不常使用到的列上建的索引是否有 必要。

    16)应尽可能的避免更新 clustered 索引数据列,因为 clustered 索引数据列的顺序就是表记录的物理存储顺序,一旦该列值改变将导致整个表记录的顺序的调整,会耗费相当大的资源。若应用系统需要频繁更新 clustered 索引数据列,那么需要考虑是否应将该索引建为 clustered 索引。

    17)尽量使用数字型字段,若只含数值信息的字段尽量不要设计为字符型,这会降低查询和连接的性能,并会增加存储开销。这是因为引擎在处理查询和连接时会逐个比较字符串中每一个字符,而对于数字型而言只需要比较一次就够了。

    18)尽可能的使用 varchar/nvarchar 代替 char/nchar ,因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。

    19)任何地方都不要使用 select * from t ,用具体的字段列表代替“*”,不要返回用不到的任何字段。

    20)尽量使用表变量来代替临时表。如果表变量包含大量数据,请注意索引非常有限(只有主键索引)。

    21)避免频繁创建和删除临时表,以减少系统表资源的消耗。

    22)临时表并不是不可使用,适当地使用它们可以使某些例程更有效,例如,当需要重复引用大型表或常用表中的某个数据集时。但是,对于一次性事件,最好使用导出表。

    23)在新建临时表时,如果一次性插入数据量很大,那么可以使用 select into 代替 create table,避免造成大量 log ,以提高速度;如果数据量不大,为了缓和系统表的资源,应先create table,然后insert。

    24)如果使用到了临时表,在存储过程的最后务必将所有的临时表显式删除,先 truncate table ,然后 drop table ,这样可以避免系统表的较长时间锁定。

    25)尽量避免使用游标,因为游标的效率较差,如果游标操作的数据超过1万行,那么就应该考虑改写。

    26)使用基于游标的方法或临时表方法之前,应先寻找基于集的解决方案来解决问题,基于集的方法通常更有效。

    27)与临时表一样,游标并不是不可使 用。对小型数据集使用 FAST_FORWARD 游标通常要优于其他逐行处理方法,尤其是在必须引用几个表才能获得所需的数据时。在结果集中包括“合计”的例程通常要比使用游标执行的速度快。如果开发时 间允许,基于游标的方法和基于集的方法都可以尝试一下,看哪一种方法的效果更好。

    28)在所有的存储过程和触发器的开始处设置 SET NOCOUNT ON ,在结束时设置 SET NOCOUNT OFF 。无需在执行存储过程和触发器的每个语句后向客户端发送DONE_IN_PROC 消息。

    29)尽量避免大事务操作,提高系统并发能力。

    30)尽量避免向客户端返回大数据量,若数据量过大,应该考虑相应需求是否合理。

    15. 使用count统计数据量的时候建议使用count(*)而不是count(列),因为count(*)MySQL是做了优化的。

    16. 二次SQL查询区别不大的时候,不能按照二次执行的时间来判断优化结果,没准第一次查询后又保存缓存数据,导致第二次查询速度比第二次快,很多时候我们看到的都是假象。

    17. 什么时候开MySQL的查询缓存,交易系统(写多、读少)、SQL优化测试,建议关闭查询缓存,论坛文章类系统(写少、读多),建议开启查询缓存。

    18. Explain 执行计划只能解释SELECT操作。

    19. 查询优化可以考虑让查询走索引,走索引能提升查询速度,索引覆盖是最快的,如下就是让分页走覆盖索引提高查询速度。
     

  • Python中 if __name__ == ‘__main__’ 的使用及一个注意事项

    Python使用缩进对齐组织代码的执行,所有没有缩进的代码(非函数定义和类定义),都会在载入时自动执行,这些代码,可以认为是Python的main函数。

    每个文件(模块)都可以任意写一些没有缩进的代码,并且在载入时自动执行,为了区分主执行文件还是被调用的文件,Python引入了一个变量__name__,当文件是被调用时,__name__的值为模块名,当文件被执行时,__name__为’__main__’。

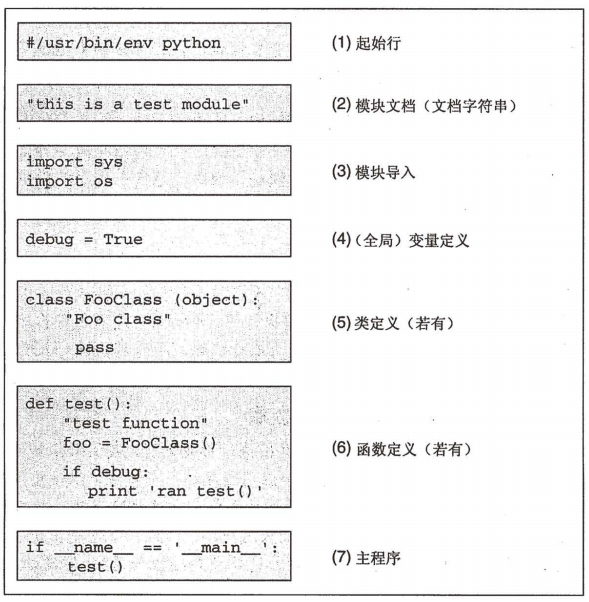
    通俗地讲:当.py文件被直接运行时,if __name__ == '__main__'之下的代码块将被运行;当.py文件以模块形式被导入时,if __name__ == '__main__'之下的代码块不被运行。

    但是在使用过程中有一个需要注意的:在计划任务下(crontab),if __name__ == ‘__main__’  是无效的。

    典型的Python文件结构:

  • 从大佬发言看走势 — 2019年乌镇互联网大会

    10月20日,第六届世界互联网大会在浙江乌镇如期举行,本次大会以“智能互联 开放合作——携手共建网络空间命运共同体”为主题,对创新发展、网络安全、文化交流、国际合作等议题进行探讨。

    今年恰逢互联网诞生50周年,也正是中国全功能接入国际互联网的第25年,在本次大会上,共包括“科学与技术”、“产业与经济”“人文与社会”“合作与治理”四大重点板块主题,设置20个分论坛,涵盖人工智能、5G、开源新品、产业数字化、金融科技、工业互联网等多个热点和前沿议题。

    以下为各位互联网企业家、投资人今日发言亮点汇总,一起来探讨一下。

    张勇:新商业文明本质要从关注流量、交易量回到人本身

    互联网的飞速发展推动着全社会向数字时代迈进,而数字化时代的商业发展又催生了新商业文明。

    在张勇看来,互联网最核心的驱动力量是消费和消费理念的变革。过去全球的互联网公司都在谈论流量,“数字化时代的新商业文明,本质是要回到人本身,从关注流量、关注交易量,到关注客户、关注消费者,关注一个个具体的人,关注全社会的效益。”

    从发展的角度来看,数字化时代的新商业文明是以合作为基石的发展新模式。张勇说:“传统竞争是此消彼长、非此即彼的零和博弈,数字化时代的竞争正在向正和博弈、共赢发展、增量发展的大趋势上演进。”

    对于已经20岁的阿里巴巴而言,张勇称,基于过去的思考与沉淀,公司已经打造出阿里巴巴商业操作系统,希望面向各行各业合作探索、推动中国各个产业全面走向数字化、智能化。

    他表示,阿里巴巴积极创造生态,既帮助了成千上万的中小企业发展,也鼓励支持新的独角兽、小巨人的发展,让大树下面既能长小草,同时也让更多的小草能长成参天大树。

    【 继续改变人们的消费方式,做好淘宝做好阿里;总感觉视野和魄力没有马爸爸厉害 】

    李彦宏:智能经济是拉动全球经济重新向上的核心引擎

    在本届大会上,围绕“智能互联 开放合作”的主题,百度创始人、董事长兼CEO李彦宏首次提到了“智能经济”新趋势。

    他指出,“数字经济在经历了PC的发明与普及,PC互联网,移动互联网这三个阶段后,正在进化到以人工智能为核心驱动力的智能经济新阶段,智能经济将给全球经济带来新的活力,是拉动全球经济重新向上的核心引擎。”

    作为中国人工智能领域的领头企业,李彦宏基于百度在该领域的积累和经验,预测了人工智能驱动下的智能经济带来的三个层面重大变革和影响:

    首先是人机交互方式的变革。“如果说过去20年是人们对手机的依赖程度不断提高的20年,那么未来20年将是人们对手机依赖程度不断降低的20年。”李彦宏指出,在智能经济时代,智能终端会远远超越手机的范围,包括智能音箱、各种可穿戴设备、无处不在的智能传感器等,人们将会以更自然的方式和机器、工具进行交流。

    其次,智能经济也会给IT基础设施层带来巨大的改变。李彦宏判断,传统的CPU、操作系统、数据库将不再处于舞台的中央,新型的 AI芯片,便捷高效的云服务,各种应用开发平台、开放的深度学习框架、通用的人工智能算法等,将成为这个时代新的基础设施。

    最后,智能经济会催生很多新的业态。交通、医疗、城市安全、教育等等各行各业正在快速的实现智能化,新的消费需求,新的商业模式将层出不穷。

    李彦宏还强调,智能经济的这三个层面并非相互割裂的,它们会互相影响,并产生化合反应。

    作为一个人工智能的乐观主义者,李彦宏还发表了对“人工智能会毁灭人类”的看法:“我的观点恰恰相反,人工智能不仅不会毁灭人类,反而可以让人们获得‘永生’ ”。

    【 都说百度再走下坡路,那是你们没有看到Robin这些年在忙活什么,人家是为社会贡献科技力量;判断一个企业是否伟大其中一个条件就是为社会带来的贡献。 】

    王兴:要满足中国消费升级,需要进行全球的供给侧改革

    美团创始人兼CEO王兴表示,数字经济最终发展起来,需要供给侧全面数字化。“需求侧的数字化是容易的,因为大家都用手机,但是供给侧数字化会慢很多。”

    他以美团举例称,“过去一年里,有4.2亿用户在我们平台上花过钱,我们合作的商户有590万。更重点的是这590万商户怎么样数字化,从他们的经营管理,他们的菜单、桌台以及他们的员工管理,还有他们的采购都要数字化,这是非常重要的事情。”

    王兴强调说,供给侧数字化是一个任重而道远的事情,“这个价值链是很长的,怎么样把供给侧价值链逐步地数字化,我认为这是巨大的机遇,同时也是很大的挑战。因为商户供给侧更理性些,是否数字化是需要算账的。”他表示,数字经济最终发展起来,需要供给侧的全面数字化。

    在发言中,王兴进一步分析说,由于供给侧涉及到全球各地,因此,“要满足中国消费升级,需要进行全球的供给侧改革。”

    【 美团也要走向世界,搭上全球数字化的列车,让人们更便捷的使用美团 】

    丁磊:看好上游技术、全球化和信息消费升级

    对于数字经济的未来,网易公司董事局主席兼首席执行官丁磊则看好三个领域:上游技术、全球化和信息消费升级。

    “未来企业的机会,要走向上游,竞争会从拼人口红利,走向拼技术。技术创新,是数字经济最牢固的支撑。”丁磊判断,未来AI等技术型的公司,会成为新的主流,和各行各业做大跨度的融合。现在对教育、医疗、制造业和农业等硬核领域敢投入的公司,未来会有更好的机会。

    另外,“未来数字化经济的发展,要从拼本土走到拼世界。”在丁磊看来,中国很多文化作品已经有能力获得世界的喜欢。未来,在优势领域,中国数字经济的全球化脚步可以走得更快。

    “我们关注的第三个领域是信息消费升级。数字经济的发展,要从拼增速走向拼质量,尽快建立可以适应未来的新数字文明。”丁磊认为,信息消费会成为影响一个人知识结构的第一来源,有能力提高信息获取效率、提供优质信息服务的企业,会成为数字经济一股新的力量。

    而在接受现场媒体采访时,丁磊也对互联网技术给予了极大肯定。“互联网发展赋予每一个普通人力量,平等获取信息、平等接受教育、平等交流沟通、平等创业就业的力量。”他指出,一个经得起考验的产业,不应该只是在资本、估值上达成共识,还应该看能否推动社会长足发展,以及是否可持续、是否有穿越周期的能力。

    【 丁磊不知道这几年在忙活啥,看样子是在搞技术创新、期待有大招 】

    张朝阳谈“三年回归互联网中心”:需要延期

    早在2016年的世界互联网大会上,张朝阳就给搜狐定下了一个目标:“三年,搜狐要重回互联网中心。”

    如今三年之期已到,张朝阳在本届互联网大会上对这个目标也做出了回应。

    “我需要一个extension(延期)。”张朝阳坦言,三年时间不够,不过在2019年,公司进入了一个比较好的状态,亏损在快速减少。

    从业务层面来看,张朝阳表示,“搜狐现在要重新学习,重新回归媒体,把媒体做好。”具体而言,回归媒体需要做好两方面:一方面,要把搜狐新闻、搜狐号以及对自媒体内容的分发做得更好;另一方面,要举办大型活动,比如跑酷活动、AI论坛等。“如果结合搜狗和畅游游戏业务的话,那么不久的将来,集团整体就会盈利,市值也会上涨。”他说。

    虽然三年目标尚未实现,但张朝阳言辞间对未来的信心溢于言表,他称,今年以来,自己把状态调的不错,全身心投入到工作中,希望把搜狐带回一个好的道路上、寻找新的爆发机会。

    【 路漫漫其修远兮 继续努力吧 曾经的偶像,不努力就是被淘汰! 】

    周鸿祎:新技术可能会产生很多安全挑战

    10月20日,360集团董事长兼CEO周鸿祎在乌镇接受媒体采访时表示,在数字经济快速发展的当下,新技术的采用可能是一把双刃剑,产生很多安全的挑战。

    “如果没有安全的保障,数字化越快,后果不堪设想。”他认为,对于网络攻击问题要能够侦测、阻断,只有保障了网络安全,才使得整个国家社会和其他行业能够更自如地或者更放心、更大胆地采用数字化技术。

    “在这个领域里面,面临的对手都是很聪明的黑客。”他认为,网络安全的本质是人跟人的对抗,近几年安全威胁变得越来越大,网络安全已经不是靠安装一套软件、硬件就能够简单地应对,未来网络安全行业一定会变成一个服务业。“同行之间应该携起手来,维护互联网安全,打击互联网犯罪。”

    对此,周鸿祎特别强调了人才对于网络安全的意义,他表示人才是网络安全最为重要的竞争要素,360也正在和很多高校合作,在今年会推出相应的网络安全培训计划。

    【 网络很危险,安全这件事够忙活一辈子了 】

    沈南鹏谈全球数字经济发展:原因之一是90后企业家扮演重要角色

    10月20日,在乌镇举办的第六届世界互联网大会“企业家高峰论坛”上,红杉资本全球执行合伙人沈南鹏表示,数字经济正在全球蓬勃发展,不仅是在中国、美国,其他诸多国家和地区如东南亚、印度、中东,甚至拉美、非洲都涌现出了一批独角兽。

    推动全球数字经济发展主要有三个原因,沈南鹏指出,第一是各国在推动数字化方面的努力;第二是90后年轻企业家在互联网中扮演者重要的角色,而这批90后是伴随着互联网成长起来的;第三是消费互联网向产业互联网转变的趋势正在加深,数字化开始渗透到各个行业,提升行业效率,“每个行业都在互联网化、数字化、云化”。

    【 对敢打敢拼的 90 后有厚望,希望能找到新的投资增长点,真的是‘风险投资’ 】

    曹国伟:网红经济已经成为新经济的标签

    在电商领域,曹国伟认为,社交媒体上诞生的社交电商和网红电商正在给电商带来的利益点,“比如说相关的公司或者个人通过运营公域流量和私域流量给电商带来了各种创新性的引流方式。”

    按照他的说法,随着社交电商和网红电商的走红,越来越多个人品牌和消费品牌在社交平台上诞生和传播,快速拉动网民的消费,产生强大的经济效益,并诞生了“完美日记”这样的新消费品牌和重庆这样的网红城市,“网红已经成为新经济的标签,预计未来会带来更大的经济效应”。

    曹国伟透露,在2019年上半年微博上关于社交电商和网红电商的GMV已经接近200亿。

    在传统媒体和社交媒体的关系上,曹国伟认为,两者的融合正在走向深入。他表示目前微博上的媒体账号数量共有3500个,这些账号在今年上半年的阅读量超过7000亿,人民日报、央视新闻等账号成为了微博上最具影响力传播力的账号。

    因此他认为,社交媒体和传统媒体不是谁取代谁的关系,前者对于后者是有帮助的,“社交媒体在传统媒体的转型和融媒体的建设上起到关键性的基础设施的作用。”

    【 继续保住社交媒体老大哥的王座 】

    雷军:明年将推出10部5G手机

    “有记者问我,你来5G关心什么,说真话,我关心5G,我特地来测试了一下5G覆盖到什么程度,所以到每个地方都测试了一下。”小米创始人兼CEO雷军在演讲开场时表示,当天上午,他在乌镇现场测试了5G速度,并把下行速度为400Mbps的截图发到微博上,“我过了一小时又测了下,有800Mbps,这个速度还行的。”

    雷军在演讲中表示,5G正在成为数字及经济发展的加速器,对整个通讯行业和互联网行业都是大事,“这是一个巨大的机会,也有巨大的挑战和风险。”雷军强调说,小米对5G的态度非常乐观、非常激动,在5G普及初期,高画质的视频应用、云游戏等都有爆发的可能性。

    “小米发布5G手机后,消费者的需求超出预期,虽然我们备了很多货,还是出现供不应求的局面,”他表示,“我们明年计划推出10款以上的5G手机,覆盖中高端所有价位,我也了解了一下,我们各家同行基本都非常乐观。

    雷军强调说,在5G的态度上,因为担心明年4G手机不好销售,所以终端厂商肯定非常激进,“我们特别希望运营商能加快5G基站的扩充速度。”

    【 5G 时代来的那么美好,既然站在了风口上 就一定要抓住 】

    姚劲波:58同城2020年覆盖所有乡镇

    58同城CEO姚劲波表示,58同城近年来十分关注下沉市场,也将利用好互联网实现下沉市场跨越发展。

    他在发言中提到,58同城的目标是在2020年覆盖所有的乡镇,帮助到六成农民实现手机收益。姚劲波称,58同城从2017年开始关注农村市场,2018年推出新品牌”58同镇“,即58要为中国4万多个乡镇搭建一个综合信息服务平台。

    “58同镇将信息下沉到县城,甚至是广大农村地区,通过发布求职、招聘、二手车房交易,农产品的销售,交通出行等综合信息,促进本地信息的流转,然后构建一个本地化社交网络,去切实满足需求的同时解决就业。”姚劲波表示。

    【 继续下沉,深耕最后一块战场 – 乡镇,要不让真的就会被弯道超车了 】

    梁建章:做投资、做互联网的人不要灰心

    携程创始人梁建章在发言中提到,创新力主要依赖于两个要素,首先是人才,包括人才的数量和质量,其次是交流,人才要互相交流,“这包括外部的交流和内部的交流,交流越多,创新力越旺盛”。

    他强调说,从今天看,年轻大学生的数量,在未来十年、二十年还会有快速增长,所以,所有面向年轻人的消费、创新力,在今后十年中,仍会有很好发展。“我认为做投资的人,做互联网的人不要灰心,我们现在还是一个非常好的上升阶段。”

    【 年轻人是主力,不管是消费能努力还是创新能力,看好当下 展望未来 】

    杨元庆:传统行业将实现智能化转型

    联想集团董事长兼CEO杨元庆表示,当下社会已经走进了一个由数据智能驱动产业变革的智能化时代,传统金融、教育、交通等都将发生颠覆性改变。

    杨元庆表示,经过过去25年发展,所有企业都会自觉自愿地“互联网化”、“数字化”,进入到传统行业与互联网、大数据、人工智能、云计算等新科技新业态融合的产业互联网阶段。

    “总结起来,主要的变化趋势体现在端、边、云、网、智五个层面上,”杨元庆分析说,“在这个架构的基础之上,利用数据,利用基础架构的计算力,利用先进的算法就能够实现各行各业的智能。我们已经进入了由数据智能驱动产业变革的智能化时代,未来传统的金融、医疗、教育、交通、通信、能源、制造业,都将在数据智能的赋能之下,发生颠覆性改变。”

    杨元庆强调,虽然中国的消费互联网刚起步时,与西方领先的互联网企业还有差距,但到了行业智能的发展阶段,中国已与西方先进企业处于同一起跑线,“未来联想将与大家一起努力,加快推进技术创新与突破,为各行各业的智能化变革和经济发展的转型升级贡献力量。”

    【 都在讨论怎样吧只能做的更好,至于怎样做只能好像是去年甚至更早就讨论了,总感觉联想还差那么点劲,不止表现在手机上 】

    陆奇:很高兴能重回创业一线

    离开百度一年之后,陆奇以奇绩创坛及YC中国创始人、首席执行官的身份现身第六届世界互联网大会,并在全体会议发言。

    “我个人非常幸运,在过去30多年第一线参与目睹了一系列的大规模计算平台的开放,以及它们所形成的产品和商业生态;从PC到互联网、移动、云计算,到早期人工智能。”过去数十年全球互联网行业发生了翻天覆地的变化,作为深度参与者的陆奇有自己思考,他认为创新是推动社会进步的力量,而技术则是创新最大最持久的驱动力。

    随着人工智能时代的到来,陆奇认为,创新和数字化的进程会更快,但同时面临的挑战也更大,开放合作的重要性会更高。“正如软件开发是互联网时代的核心产能,数据也将成为人工智能时代和核心产能”,因此他认为需要在政策、基础建设、科研、技术、产品,和商业模式上作更多的探索和努力,建立新一代像开源软件一样的机制,来保护好数据隐私和数据价值,并能提供更强大的合作机制。

    在谈到挑战的同时,陆奇也对新时代到来产生的新的创业机会感到乐观,从微软、苹果、亚马逊、BAT的历史来看,技术驱动的创业公司能从0到1到100这样来建立创新平台,“我们需要一个更加繁荣、更为技术驱动的早期创业生态。”

    “我很高兴我能在中国的早期创业生态重回一线。”陆奇表示,经过一年多的准备工作,他和他的团队已经成立了一个名叫“奇绩创坛”的早期创业生态的新物种,推进的第一个产品是YC中国,希望将YC美国过去15年非常成功的基于技术驱动的创业公司的模式和基因完全本地化。

    【 不可小瞧的一个人物,希望能带来新的互联网革命 】


    突然想到上个月看到的关于老干妈的版权矩阵,及时、上百个点的布局只为保护中间的“老干妈”品牌;互联网企业起始也是这样,只是在布局每个点的时候更为大手笔,因为 竞争对手可能来自一个和你不相干的领域。

  • 新生代阿里“掌门人”

    当一家公司的员工从18名增加到超过10万名,由谁来管理就成了最重要的决定,阿里就处在这样的十字路口。创立二十年,阿里已成为全球市值第六的科技公司,旗下业务更是涵盖电商、金融、云计算、物流、文娱、健康、体育等,甚至囊括了线下实体商超和本地生活服务。以往阿里同事要沟通只要转个身就行,如今可能跨越另一种语言和另一个时差。去年的9月10日,马云宣布将交棒阿里CEO张勇。此后的一年里,阿里大小组织变化不断,张勇先后调整了电商、云计算、大文娱等业务部门的负责人,又通过平行调换,将业务线和职能线的高管交换。这对习惯了“两年一小换、五年一大调”的阿里员工来说,原本习以为常,但这一次不同的是,马云将彻底交出指挥棒。阿里“掌门”交接,新生代管理层也开始崭露头角。接过阿里接力棒的70后张勇背后,新一批高管名单中80后也开始出现,而他们的客户已经是90后,甚至是00后。80后合伙人蒋凡如果单纯以营收来看,身兼淘宝和天猫两个业务总裁职务的80后蒋凡无疑是阿里最重要的高管之一。2019年4月,美团CEO王兴在朋友圈评论,要能打赢拼多多这一仗,“(蒋凡)那就是当之无愧的阿里CEO接班人,如果他有兴趣干这活的话”。

    蒋凡。图/视觉中国

    2008年从复旦大学毕业后,蒋凡曾在谷歌做了两年广告和地图业务。2010年,蒋凡加入李开复的创新工场,担任项目负责人。他做的业务是友盟,业务是提供移动应用统计分析服务。友盟成立第三年被阿里收购。被收购后,蒋凡本打算离开阿里,时任阿里COO的张勇出面挽留了他。一杯茶,一句话,于是,2013年成了蒋凡人生的拐点。当时正值阿里提出“All in无线”战略,张勇将蒋凡托付给了时任淘宝总裁的张建锋,开始做手机淘宝,头衔是资深总监。当时,阿里否决了大部分的应用开发计划,却将手淘的地位提升。2013年之前,手淘只是一个工具,可以搜索、购买和查询物流,连基本的导购、交流互动都没有。2014年,蒋凡接手后,改变了手淘和PC端的差异,将产品无线化,并通过“扫码”战略获取流量以及开放手机淘宝。在随后的两年中,手机淘宝日活用户从3000万飙升超过1亿,淘宝的无线交易占比也从百分之十几增长至80%以上。2015年,在张勇直接管理的零售电商事业群,蒋凡进入了“班委”,担任淘宝产品平台资深总监。2017年,蒋凡曾负责管理淘宝新选,但很快便被提拔为淘宝总裁。与来自传统品牌和零售企业的时任天猫总裁靖捷不同,蒋凡在张勇的评价中是,“推动了淘宝走向数据驱动,实现千人千面”。在这一时期,蒋凡主导了淘宝内容化战略,解决了引导用户在淘宝平台“逛”的需求。2019年,阿里新一轮组织架构调整后,蒋凡开始兼任天猫总裁。阿里希望在保持两个品牌独立发展的同时,打通消费场景,实现分层运营。这个职位的难度更高,此前除了张勇,历任天猫总裁的任期都只有一年左右。这对刚刚成为阿里合伙人的蒋凡来说无疑是一个巨大的考验,而他已经定下个目标,未来三年,天猫交易额翻番,也就是要达到四万多亿,每年要保持30%以上的增长。“土生”高管张建锋与蒋凡同样被关注的另一个阿里高管就是张建锋。一位熟悉这两个人的人士告诉记者,两个人共同的特点就是低调,甚少面对媒体,不同的是,相对后来加入的蒋凡而言,张建锋是阿里的“老人”。毕业于浙江大学的张建锋,2004年加入阿里任职淘宝技术部架构师。第七年的后半年才开始从技术走向管理,随后他主管过B2B业务1688、聚划算、本地生活等。

    张建锋。图/视觉中国

    2014年初,张建锋重新回到淘宝,担任总裁。这一年,阿里与京东的价格战拉锯,马云放话称对成绩不满意。张建锋在一次演讲中罕见发声:“京东一半市值来自于资本对于阿里的期待”。一年后,天猫前总裁王煜磊被马云罢免,张建锋开始身兼天猫职务。在蒋凡负责手淘时,张建锋为其提供了支持,尤其是在淘宝网、手淘和一淘合并的过程中。事实上,从技术、框架选择,到编写代码、运营以及产品设计,张建锋是少数几个亲历淘宝发展整个过程的人。他曾对媒体表示,“很多事情我都是参与过讨论的”。2015年底,阿里推行“大中台、小前台”战略,张建锋出任新设立的中台事业群总裁。张勇表态,张建锋是集团内为数不多的兼具技术、商业背景和经验的领导者。2016年,张建锋接替王坚出任集团首席技术官,除了继续带领中台事业群团队,他还负责技术保障部。2017年,张建锋开始执掌阿里研究机构达摩院;2018年底的组织架构调整中,张建锋出任升级后的阿里云智能总裁。有知情人士表示,张建锋的地位提升与阿里的中台战略有关。一位近期与张勇有过沟通的业内人士告诉记者,张建锋和蒋凡都在执行张勇对阿里的战略,不同的是,张建锋是流量派,而蒋凡是数据派。当前阿里的状况是,想要向数据转型,但割舍不下流量的生意。“少壮派”王磊在少壮派高层中,1980年出生的王磊加入阿里的时间甚至早过张勇。自2003年开始,王磊曾先后在客户管理业务、广告业务和无线业务任职。2013年9月,王磊开始担任阿里淘点点事业部总经理,但直到他接任阿里健康CEO之前,外界对他的关注甚少。

    王磊。图/视觉中国

    自阿里健康开始,王磊一直负责阿里对外收购后的整合。2014年1月,阿里以1.7亿美元战略投资中信21世纪,同年10月,中信21世纪改名为“阿里健康”,时任首席技术官的王坚担任首席执行官。2015年4月,王坚辞职,王磊接任。阿里创业期的“十八罗汉”之一的吴泳铭担任董事会主席。事实上,健康业务是马云“双H战略”的一半,另一半是“快乐”(娱乐)。2015年,阿里上市后的首份年报中,马云写给投资者的信中提到,狭义的电子商务仅仅是今天阿里集团战略的一部分,而十年后基于数据技术的健康和数字娱乐业务具有重大战略意义。在王磊担任阿里健康CEO三年后,阿里收购饿了么。收购完成后,饿了么与口碑将整合成为一家新公司。这个新公司是阿里近期以来最大张旗鼓宣布成立的子公司,王磊接手管理这家公司,出任公司总裁,并兼任饿了么CEO。对于这家子公司,阿里宣布是集团完成大消费领域布局的重要里程碑,但在外界看来,这是与美团竞争的开始。在本地生活业务方面,第一步饿了么和口碑将着重“到家”和“到店”两个场景,未来,饿了么和口碑也将与阿里零售业整合,既包括阿里系的盒马鲜生、银泰百货、高鑫零售,也包括独立零售品牌星巴克等。作为新零售业务载体之一的负责人,王磊在阿里高层的地位随之提升。此前媒体披露的经济发展执行委员会13人组成名单中,未能看到高德董事长俞永福、大文娱总裁樊路远和菜鸟总裁万霖等人的身影,但王磊却在这份名单之中。守疆大将樊路远2007年以资深总监级别加入阿里的樊路远(原名樊治铭),曾亲自指挥了奠定支付宝地位的快捷支付和余额宝项目,如今坐镇阿里大文娱担任总裁。虽然并未进入经管会13人名单,但樊路远仍是阿里不可缺少的。

    樊路远。图/视觉中国

    阿里2018年底到现在的新一轮架构调整中,只有大文娱业务的管理层变更。这不仅是因为战略的需要,也由于优酷原总裁杨伟东配合警方调查,阿里影业董事长樊路远兼任优酷总裁,并且他刚刚接替杨伟东成为新一任阿里大文娱轮值总裁。娱乐作为马云“双H战略”的另一半,在阿里的财报上一直是亏损大户。就在樊路远兼任后,阿里影业被并入集团业绩报表,但目前来看尚未产生影响。樊路远接手优酷后不久,外界便传言优酷被出售的可能,樊路远的回应十分干净,“绝不可能”。如今,樊路远既要寻找杨伟东的接替者,又要为大文娱整体打开新局面。接管优酷后,他在第一封内部信上就表态,“近期将进行全面内部整顿”。一位大文娱的基层工作人员告诉记者,在接管之后,樊路远要求所有人必须在九点之前到岗,而在这之前大家闲散的时候中午午饭时间能够见到彼此就已经是常态。樊路远还推动了内容原创板块整合,人员精简。与对内强硬的措施不同,樊路远在公开场合很低调。不同于电影大佬们的侃侃而谈,樊路远更愿意用笔和纸记录聆听,轮到他发言,才表出态度。在做业务上,樊路远懂得放大招。2014年滴滴和快的“激战正酣”的时候,快的的补贴永远比滴滴多1块的方案,就是樊路远的主意。事实上,在樊路远领导下,支付宝曾与银行有过一场博弈。2010年,用户网络交易需要跳转电子银行支付,但受限于口令卡、U盾等工具的繁琐过程,支付成功率在80%左右。支付宝曾希望银行开放接口,但银行想以自家品牌触达用户。后来,他带队做出了“快捷支付”。樊路远领导的另一场战役是余额宝。2012年底天弘基金总经理周晓明第一次见到了樊路远,他很快便决定“这个事可以做”。2013年上线后,凭借一度超过6%的年化收益率,支付宝用户账户余额大量涌入余额宝。这不仅解除了支付宝备付金风险,也推动了更多用户下载使用支付宝。直到年底,微信红包的出现,才将支付宝拉回竞争。


    来源:新京报